본문으로 건너뛰기
노리터해외반응
여기 사실 휴대폰 커뮤니티임.성지 시세, 알뜰폰 요금 비교표직접 모아 가격순으로 보여줌11-06 확인 · 판매처 55곳 · 요금제 3,319개

해외반응

RTX 5090 실거래가가 9천 달러 넘었다는 글에 나온 반응
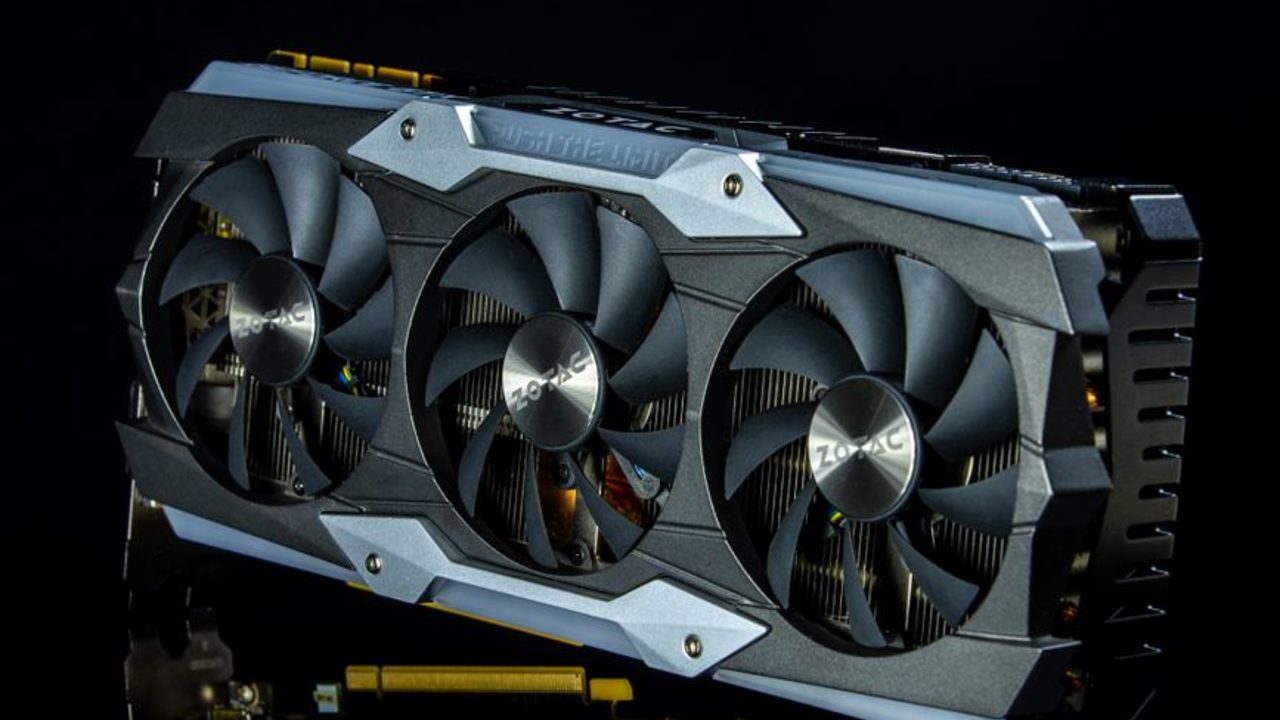
RTX 5090 실거래가가 9천 달러를 넘었다는 글에 해외 커뮤니티 반응이 모였음.

최상급 게이밍 PC 견적을 내보고 놀랐다는 사람부터, 예전엔 최고급 부품을 바로 사던 지인들마저 가격 때문에 망설인다는 얘기까지 나옴. 그래픽카드뿐 아니라 SSD 가격도 올랐다는 경험담이 붙었고.

댓글에서 특히 길게 이어진 건 로컬 AI 얘기였음. 비싼 GPU라도 직접 모델을 돌리면 데이터가 밖으로 나가지 않고 사용량 제한도 피할 수 있다는 쪽이 있는가 하면, 전기료와 장비값을 생각하면 구독이 더 경제적이라는 반론도 나옴.

성능 평가도 갈렸음. 코딩 작업 대부분에 충분하다는 사용자가 있는 반면, 복잡한 전문 작업에서는 클라우드의 최고 성능 모델과 차이가 크다는 경험담도 있었음.

한편 한 사용자가 그래픽카드를 사서 90일 동안 쓰고 반품하는 조건으로 클라우드 요금과 비용을 비교하면서 논쟁이 붙음. 본인은 거래의 위험을 계산한 거라고 했지만, 다른 사람들은 반품을 사실상 무료 대여처럼 계산한 데다 모델 성능도 다르다고 지적했음.

별도 GPU와 전용 메모리가 앞으로도 필요할지, AI 렌더링과 통합 메모리가 그 구조를 바꿀지도 토론거리였음.[1]
출처

  1. ↑ Hacker News

#RTX 5090#그래픽카드#GPU 가격#로컬 AI#PC 하드웨어

번역 및 요약 과정에서 일부 내용에 오류가 있을 수 있음.

신고

해외반응 49수집된 해외 반응

  1. Kev*****ynn

    GPU를 직접 보유하는 비용과 토큰값을 비교해 봤음. 지금 아마존에서 RTX 5060 Ti 16GB가 약 800달러임. 전기요금이 저렴한 시간대에 하루 18.4시간 돌리면 한 달에 약 1억 930만 토큰을 처리할 수 있음.

    이 카드는 90일 반품 가능 기간이 있음. 3개월 쓰고 반품한다면 신용카드 이자와 전기료를 합쳐 실제 지출은 총 80달러. 같은 기간 하루 18.4시간 사용량을 AI 업체에 내면 1,639.50달러가 나왔음. 80달러 대 1,639.50달러라니, 이 정도면 거품 아닌가 싶음.

    물론 대기업이나 대형 프로젝트에 GPU 100개 이상이 필요한 연구자는 자체 슈퍼컴퓨터가 없는 한 사정이 다르겠지. 이건 집에서 혼자 코딩하는 사람 기준임. 요약하면 반품 기간을 일종의 90일짜리 선택권처럼 계산한 거임.

  2. embe*******hape

    그래, VRAM 16GB에서 컨텍스트 길이 1만으로 돌리는 Qwen 3B가 비교 대상인 구독 서비스의 모델과 정말 비슷하겠지? 구독 쪽도 3B 모델에 접근하는 비용인 거고? 실제로 이런 비교를 하기 전에 사용 사례를 고려해야 할 듯.

    나도 1년 전에 GPU를 약 1만 유로 넘게 주고 사면서 비용을 따져 봤는데, 일기나 재정 정보처럼 아무 제3자에게나 보낼 수 없는 사적인 내용을 분석하는 데 쓰기 때문에 내겐 값어치를 매길 수 없었음. 하지만 안타깝게도 VRAM 96GB로 돌릴 수 있는 최고의 모델조차 호스팅되는 최고 성능 모델에는 한참 못 미침.

  3. Kev*****ynn

    작은 모델도 하네스와 오케스트레이터 안에서 쓰면 실무에 충분히 정확할 수 있음. 특히 작은 모델 여러 개를 조합하거나 서로 검증하게 하면 더 그렇고.

    5060이 가격 대비 가장 빠른 카드는 아니었지만 어제 기준 가격 대비 VRAM이 가장 많았음. 4070 Ti가 있는 PC에 같이 설치해서 두 모델을 동시에 돌릴 예정임. Paperclip이나 Multica로 코딩 모델과 MoE 모델을 함께 쓰려고 함.

해외 반응 46개 더 보기
  1. Tec******ech

    지난 몇 달 동안 로컬 Qwen3.8용으로 5090을 두 장씩 넣은 PC 여섯 대를 구성했음. 가격은 엄청 비쌈.

    설정과 하네스를 제대로 갖추면 코딩용 로컬 AI 성능이 아주 좋고, 우리 사용 사례의 95%에서는 폐쇄형 모델과 비슷함. 최종 사용자는 사용량 제한 없이 쓸 수 있고 토큰 생성 속도도 빠름. 커뮤니티 최적화 덕에 몇 주마다 계속 나아지고 있고.

    데이터가 로컬에 남으니 미국 CLOUD법과 관련된 곳으로 데이터가 가지 않아 EU 규정 준수 확인도 훨씬 쉬움.

  2. AL****en

    최고급 GPU가 550유로였고 오버클럭에 커스텀 외장, 수랭 준비까지 된 버전도 최대 660유로였던 시절이 기억남.

    2025년 1월 출시된 5060 Ti가 800달러인 것부터 지금 GPU 가격은 어느 것도 납득하기 어려움. 다른 시장은 이 정도로 심하지 않은데 GPU만 초대형 불황을 겪는 것 같음.

  3. we****kj

    서로 다른 걸 비교하고 있음. 1억 900만 토큰은 가볍게 써도 하루 만에 쓸 수 있는 양임. 토큰당 가격으로 비교하면 클라우드 업체도 아마 훨씬 비슷할 거임.

    그것도 아직은 클라우드 AI 서비스와 판매점 반품 정책을 이용하는 방식을 공정하게 비교한 게 아님. 최고 성능 모델에 어느 정도라도 근접하는 쓸 만한 로컬 모델은 VRAM 16GB에 들어가지 않으니까.

  4. Kev*****ynn

    무슨 악용이라는 거임? 반품 기간 말하는 건가? 89일 뒤에 업그레이드하는 게 경제적으로 유리하지 않은 이상 반품할 생각 없음. 핵심은 이 거래에서 내가 감수하는 위험을 계산하는 거였음.

    총 80달러의 위험으로 3개월 동안 프로그래머 10명 이상 분량의 작업을 얻을 수 있음. 토큰마다 돈을 내는 것보다 훨씬 나은 선택이라고 봄.

  5. p**l

    그 비교는 말이 안 됨. 판매 시스템의 허점을 이용해 하드웨어 비용을 아예 안 내는 걸 전제로 하잖아. 다만 하드웨어 비용을 포함해도 전체적인 결론은 크게 달라지지 않는 것 같긴 함.

  6. s**a4

    아직은 그렇다는 거지. 난 실제로 Qwen3.8-flash-next를 Playwright MCP 도커와 함께 돌리고 있는데, 스크래핑에서는 내 ChatGPT나 Claude 구독보다 훨씬 나음. 단순히 사이트들이 Playwright에 거짓 정보를 주지 않기 때문임.

  7. t***oc

    나도 비슷한 계산을 좀 더 폭넓게 해봤음. 모델마다 다르고 FP8에서 얼마나 성능을 낮춰 양자화할지에 따라서도 달라지니까. 어떤 모델은 로컬 하드웨어에서 너무 느려서 사실상 실용적이지 않음. localaicost.com

  8. cr****101

    모두가 아마존에서 카드를 사서 90일씩 쓰고 대거 반품하는 걸 칸트 윤리가 지지할지는 모르겠음. 이건 직접 운영하는 비용과 추론 서비스를 이용하는 비용을 비교한 얘기라기보다, 남을 고려하지 않는 편법에 가까워 보임.

  9. pri******hate

    ‘설정과 하네스를 제대로 갖추면’이라고 했는데, 어떤 구성으로 쓰는지 정말 궁금함. 좀 더 자세히 설명해 줄 수 있음?

  10. Kev*****ynn

    허점을 악용하는 게 아니라 거래의 ‘위험’을 계산하는 거임.

  11. us****928

    당신에게 효과가 있다는 건 의심하지 않음. 하지만 구체적으로 어떤 작업을 하는지는 모르겠어도, 그 말을 일반적인 주장으로 받아들이면 Opus 5.5와 로컬 모델이 만든 웹사이트를 나란히 놓는 것만으로도 쉽게 반박될 것 같음.

  12. k***ij

    강하게 양자화한 100억~300억 파라미터 모델을 수조 파라미터짜리 모델과 비교하고 있잖아. 평생 AI를 딱 3개월만 쓸 게 아니라면 가격이 절반이어도 그리 좋은 거래는 아님.

    다만 프라이버시와 자유는 얻을 수 있음. 누구도 더 많은 돈을 받으려고 멋대로 이용 약관을 바꿀 수 없으니까.

  13. cat******4321

    판매자 비용으로 대여한 셈 치려고 사용한 제품을 반품하는 거라면, 솔직히 판매자만큼이나 당신도 문제의 일부임.

  14. r***sz

    그것도 모델을 평가하는 지표 중 하나임. 프런트엔드 작업을 한다면 꽤 관련성 높은 지표일 거고.

  15. Thu******zzle

    내가 보니 GPU 한 장에 770달러, VRAM 1GB당 48달러임. 지금은 아마 VRAM 용량 대비 가장 저렴할 듯.

    다만 몇 달 전 R9700은 32GB에 1,350달러, GB당 42달러였음. 다들 그걸 알아서인지 지금은 공급 문제까지 겹쳐 약 1,800달러가 됐고.

    시장이 쓸 만한 최소 용량은 32GB라는 걸 알아낸 것 같음. 그래야 Qwen3.8 Q6를 10만 이상의 컨텍스트와 함께 전부 VRAM에 올릴 수 있음. 24GB로는 안 되고.

  16. Tec******ech

    워크플로를 계속 개선 중이고 거의 매주 좋아지고 있음. 현재 구성은 자체 GitLab 프로젝트 구조에 OpenCode와 Mattpocock/skills를 더하고, 목표 정렬·계획·구현·검토·학습 과정을 명확하게 정해 놓은 방식임.

    지난 몇 달 사이에 상황이 바뀐 느낌임. 올해 초에는 불가능했는데 이제 Claude 같은 서비스 없이도 필요한 일을 실제로 할 수 있게 됐음.

  17. Yet*******Nick

    우선 GPU 시간당 비용을 0.048달러로 가정한 건 오해의 소지가 큼. CPU나 냉각 등 여러 비용을 빠뜨렸고, 실제로는 두 배에도 팔 수 있음. Vast.ai는 0.12달러임.

    또 수천억 파라미터 모델을 16GB에 어떻게든 넣고 계산대로 초당 200토큰을 돌릴 수 있다고 가정하더라도, 혼합 비용은 1,639달러가 아니라 100달러 정도일 거임.

  18. Tr****rFF

    며칠 전에 최고급 게이밍 PC를 맞추면 얼마인지 알아봤는데 1만 2,500달러가 나왔음. 너무 비쌈.

    돈 잘 버는 게이머 친구들도 있는데, 항상 최신 플래그십 부품이 나오자마자 사던 사람들조차 가격이 너무 심하다고 구매를 늦추고 있음. 90년대 초반 가격으로 돌아간 느낌임.

    추가: 당연히 게임하는 데 RTX 5090이 꼭 필요한 건 아님. 다만 이제 최고급 GPU 시장은 로컬 LLM 사용자 전용이 된 것 같음.

  19. lite*******vark

    문제는 로컬 AI도 프롬프트를 조금 바꾸면 올바른 결과를 얻을 수 있다는 거임. 프런트엔드는 이미 몇 년 전에 해결된 문제임.

  20. Kev*****ynn

    반품해도 된다고 했고 90일 평가 기간을 줬잖아. 업체에도 이득이 있으니까 그렇게 한 거겠지. 난 정가보다 35%나 더 내고 샀는데 내가 욕심쟁이라고?

    카드 가격을 한탄하면서 계속 기다릴 수도 있고, 시장을 분석하고 프로젝트의 위험을 계산한 다음 자신 있게 진행할 수도 있음. 남이 행동하는 걸 옆에서 비난만 할 수도 있고. 선택은 각자 하는 거지.

  21. Thu******zzle

    작년에 TeamGroup 2TB SSD 두 개를 개당 약 100달러에 사서 홈서버에 RAID로 묶었음. RAID가 필요했는데 삼성 제품 등의 절반도 안 되는 가격이었거든. 예산이 빠듯해서 비싼 거 하나를 중복 구성 없이 쓰는 것보다 저렴한 걸 중복 구성으로 쓰기로 했음.

    그런데 똑같은 제품이 지금은 개당 300달러에 가까워지고, 18개월 전 300달러였던 삼성 제품은 500달러가 됐음. 가격이 너무 심함.

  22. Kev*****ynn

    거래하기 전에 재정적 위험을 계산하는 게 문제임? MBA 과정에서는 그걸 책임 있는 기업 경영이라고 부름.

  23. th****es

    난 노트북용 5090 24GB밖에 없는데도 Strata에서 Qwen3.8 Flash IQ3_XXS를 컨텍스트 128K로 초당 110~140토큰 돌릴 수 있음. Artificial Analysis 벤치마크가 의미 있다면 GPT 5.6 Terra/Sol 사이쯤 되는 성능임.

    그 모델과 Codex/Sol 6.1을 각기 다른 프로젝트에서 일주일 대부분 사용함. 로컬로 작업한다고 딱히 큰 손해를 본다는 느낌은 안 듦. 가장 큰 문제는 속도임. 추론 시간이 더 필요하고 한 번에 작업 하나만 할 수 있음.

  24. us****928

    프롬프트만 조금 바꿔서는 안 될 것 같지만 피드백을 반복해서 주면 가능함. GPT-5.4나 GPT-5.5로도 우리가 원하는 괜찮은 프런트엔드를 충분히 만들 수 있었고, 아예 직접 코딩해도 되겠지. 그래도 Opus 5.5로 더 빠르고 잘 만들 수 있는데 예전으로 돌아가고 싶진 않음.

  25. Kev*****ynn

    품질은 카드 용량이 아니라 모델과 모델 크기에 따라 결정됨. 반품 정책이 악용됐다는 건 네가 상상한 거고, 계획은 오늘 카드 한 장을 사는 거였음. 제대로 읽어 봐.

  26. cat******4321

    아니, 말했듯이 내가 문제 삼는 건 거래를 한 뒤 상대방에게 비용을 떠넘기면서 그 거래를 되돌리는 행동임. MBA에서 그걸 어떻게 그럴듯하게 포장해 부르는지는 중요하지 않음.

  27. Kev*****ynn

    우리가 살아야 하는 환경은 우리가 어떻게 생각하든 신경 쓰지 않음. 적은 비용으로 그 환경에 정확히 적응하는 게 중요하다고 봄. 사람들은 환경이 마음에 안 드는데, 거기에 적응하려는 내 글을 공격하기로 한 것 같음.

    구매 주문으로 전 세계 GPU의 40%를 확보해 놓고도 실제 구매 의무는 없다는 그 샘이라는 사람보다 내가 훨씬 쉬운 표적이겠지. 이 생각은 얼마 전 매출이 0달러인데 토큰에 월 310만 달러를 쓴다고 자랑한 ‘비디오 게임 제작 도구’ 개발자 기사를 보고 시작됐음.

  28. Ga****321

    실제로 효과가 있다는 말은 믿지만, 지금 저 PC들을 맞추는 비용을 생각하면 특히 전기료가 비싼 유럽에서는 구독을 사는 것보다 경제성이 떨어질 거임. 이런 구성을 쓰는 이유는 데이터 주권이고, 실제로 그게 필요한 경우는 많음.

  29. embe*******hape

    무슨 문제가 있냐고? 계산이 ‘처음부터 반품할 생각으로 하드웨어를 산다’는 전제에 기대고 있잖아. 그건 반품 제도를 악용하는 거라고 봄. 살 때는 보유할 생각으로 사고, 빌릴 거면 대여업체를 찾아야지.

    반품할 계획이 없다면 최소한 GPU 구매비는 비용에 넣어야 하는 거 아님? 반품할 생각이 없다면서 왜 반품을 전제로 계산함?

  30. prm*****che

    이게 전부 RAM 때문에 일어난다는 게 신기함. RAM 16GB인 5070 Ti는 1,500유로 미만인데 RAM 32GB인 5090 Ti는 1만 2,500유로로 거의 10배임. RAM 24GB인 RTX Pro는 4,000유로 미만에 있고.

  31. prm*****che

    8GB 이하 GPU는 괜찮은 가격에 찾을 수 있음. 오래됐거나 저가형인 제품들도 1년 전보다는 비싸졌지만, 코로나와 코인 채굴 시기만큼 심한 건 아님. 아마 그 PC도 그때쯤 맞췄을 것 같고.

  32. mi***yp

    5090은 정말 강력한 GPU임. RAM도 이유 중 하나겠지만 그냥 카드 자체가 좋음. 게임과 가벼운 AI 작업용으로 샀는데 지금은 ninfer와 dreamcoder.ai에서 Qwen 3.8 27B를 돌리고 있고 엄청 빠름. dreamcoder.ai는 내가 관련된 서비스임.

    프리필은 초당 약 2~3천 토큰이고, 컨텍스트는 256K, 생성 속도는 초당 약 150토큰임. 난 코딩 경력 30년인데, 그 작은 모델이 Opus 5.5급은 아니어도 능숙한 개발자가 쓰면 코딩을 아주 잘함.

  33. ticu*******line

    PC 맞출 때 무리해서라도 5090을 살걸 후회 중임. 중고라도 가치가 오를 것 같긴 했는데, 출시 당시에도 이미 비싸고 권장가보다 한참 높아서 선뜻 사기가 어려웠음.

  34. bo****yer

    지금 쓰는 GPU가 10GB RTX 3080인데, 이보다 성능이 떨어지지 않는 제품으로 바꾸려면 최소 1,000캐나다달러는 써야 함.

  35. g**s

    사람들이 자기가 가진 카드의 가치를 더 알아채고 가격을 두세 배로 올리기 전에, 지금 마음먹고 중고시장에서 괜찮은 카드 하나 사는 게 나을 듯.

  36. r*z

    별도 그래픽카드라는 개념이 점점 끝나가는 것 같음. 컴퓨터 그래픽이 DLSS 같은 로컬 AI 기술을 점점 더 활용하는 방향으로 가고 있잖아. 단순한 형태와 그림자만 직접 렌더링하고 실시간으로 AI 실사 필터를 적용하는 식으로.

    게이밍 PC에 GPU 전용 메모리와 나머지 시스템 RAM을 따로 두는 걸 정당화하기가 점점 어려워질 듯. 개인용 컴퓨터의 다음 단계는 통합 메모리라고 보고, 업체들도 마니아용 업그레이드 PC를 더 모듈식으로 구성할 방법을 내놓을 거라고 생각함.

  37. Tad*****181

    DLSS도 그 작업을 하려면 별도 하드웨어가 필요하고, 세대가 바뀔 때마다 새 하드웨어를 요구하잖아. RAM 종류도 달라서 장단점이 완전히 다름. CPU에 GDDR을 쓰면 지연 시간이 한 자릿수 차이로 나빠져 성능이 떨어지고, GPU에 DDR을 쓰면 대역폭이 그만큼 부족해 게임이 슬라이드 쇼가 될 거임. CPU와 메인보드가 작동하는 방식 자체를 다시 설계해야 하고, AMD와 엔비디아가 메인보드와 일반 소비자용 RAM 제조사의 연결 장치에 지금보다 더 의존하는 데 동의해야 함.

    통합 시스템은 특정 하드웨어에 맞춰 고도로 최적화된 모바일과 노트북에서 많이 발전했음. 그래도 모든 게 잘 풀린다 해도 5090에서 DLSS 5는 프레임을 절반으로 줄이고 5090이 필요함. 표현 방식도 거칠고 대비가 강한 조명의 실사풍 하나뿐이고.

    10년 뒤 새 GPU가 주로 AI 처리 장치가 될까? 아마 그럴 거임. 그래도 별도 부품일 거고, 렌더링의 기반이 되는 래스터화와 레이 트레이싱 파이프라인도 상당 부분 남아 있을 듯. 물론 AGI가 나와 하드웨어가 하룻밤 사이 근본적으로 바뀔 수도 있겠지만.

  38. ja****ll

    GPU 하드웨어, 그것도 내가 알기로는 AI 추론을 가속하는 GPU 하드웨어에서 돌아가는 DLSS가 어떻게 GPU를 없앤다는 거임? 그리고 모듈식으로 업그레이드할 시스템이라면 GPU와 CPU를 한 모듈로 합치는 게 무슨 도움이 됨?

    다만 메모리 컨트롤러를 CPU에서 분리하고 교체 가능한 CPU와 GPU, 나아가 저장장치와 네트워크 컨트롤러까지 하나의 RAM 풀에 안전하고 빠르게 접근하게 하는 구조라면 흥미로울 듯. 게임뿐 아니라 오히려 다른 분야에서도.

  39. ja****ll

    그건 8GB 카드임. 게임용이라면 DLSS 등을 쓸 수 있는 비교적 최신 8GB 카드, 예를 들어 3070을 중고로 300달러 미만에 구할 수 있음. 1070 Ti에서 확실한 업그레이드가 될 만함.

    비슷한 카드가 몇 년 전에는 비슷한 가격의 신품으로 팔렸으니 좋은 상황은 아니지만, 적어도 고급형처럼 권장가의 몇 배에 거래되지는 않음.

  40. r*z

    DLSS가 특정한 칩 패키징 방식을 요구하는 건 아님. 엔비디아 소프트웨어에 맞춘 최적화 문제만 해결하면 DGX Spark나 애플 M 시리즈의 GPU 코어에서도 못 돌릴 이유가 없음.

    미래 PC는 일반 CPU 소켓과 GPU 소켓이 따로 있고 둘 다 고대역폭 통합 메모리에 접근하는 메인보드를 쓸 수도 있을 듯. 지금은 대역폭과 전력 효율 때문에 통합 메모리를 칩에 아주 가깝게 납땜해야 하지만 언젠가 이 한계를 우회할 방법이 나오면 좋겠음.

    일반 소비자용이라면 CPU와 GPU 코어를 같은 다이에 넣어도 되겠지만, 전문가나 마니아는 GPU 코어를 더 늘리는 식으로 기존 구성보다 자유로운 조합을 원할 테니까.

  41. r*z

    그 기술은 나온 지 얼마 안 된 초기 단계임. 그래도 난 그게 컴퓨터 그래픽의 미래라고 생각함. 실제에 가까운 복잡한 기하 구조와 조명을 전부 렌더링하는 대신, 아주 단순한 장면을 만든 뒤 대부분이 차이를 구별하기 어려울 정도의 실사 필터를 씌우는 거지. 앞으로는 실사 말고 다른 스타일도 충분히 표현할 수 있을 거라고 봄.

    그리고 우리가 ‘별도’라는 말을 다르게 쓰는 것 같음. 내가 이해한 별도 GPU는 자체 메모리가 달린 독립 장치, 그러니까 지금 PCIe 슬롯에 꽂는 물건임. 내가 잘못 이해했을 수도 있지만.

  42. la****sea

    개인적으로 Qwen 모델을 많이 쓰는데 최고 성능 모델과 동급은 아니어도 확실히 쓸 만한 수준까지 왔음. 특히 하네스 엔지니어링에 공을 들이면 꽤 유용함. Qwen4가 나오면 같은 결과를 얻는 데 필요한 작업은 줄고, 새 모델의 약점에 맞춰 똑같이 공을 들이면 지금의 최고 성능 모델에 더 가까워질 거라고 봄.

    Unsloth의 DeepSeek V4.1 Flash 1017 IQ1_M 양자화 모델도 성능을 유지하는 걸 보고 놀랐음. 이것까지 로컬에서 돌아가다니 새로운 시대인 듯.

  43. la****sea

    8GB 카드도 가격이 오를 수 있음. 나도 최근 보조 모델을 돌리려고 저렴한 카드 하나를 샀음. 기억 정리나 의사결정용 소형 LLM 같은 것들 말임.

    로컬 멀티 GPU도 꽤 재미있음. 한 GPU가 다른 GPU들을 이끌게 하고 조합하면서 점점 더 강력한 작업을 할 수 있음.

  44. li****st

    6000 한 장 대신 5090 두 장을 쓴 이유가 궁금함. VRAM이 각각 96GB 대 64GB잖아. 이론상 성능은 5090 두 장보다 6000이 떨어지겠지만 텐서 병렬 처리 오버헤드와 느린 PCIe를 생각하면 실제론 비슷하면서 전력 소비와 발열은 절반도 안 될 것 같은데.

  45. r*z

    나도 그렇게 생각함. 메모리가 생산성의 주된 병목이 되는 상황에서 일반 RAM과 GPU 메모리를 따로 두는 건 분명 비실용적이고 지속하기 어려움.

  46. l**2

    내 생각에 그런 벤치마크는 얼마든지 유리하게 만들 수 있어서 크게 믿지 않음. 지금 빠른 무인기 설계 반복 작업을 위한 CAD·공력·CAM 통합 소프트웨어를 만들고 있는데, 공개 모델들은 이 작업을 별로 잘 못함.

    아주 자세한 명세와 TDD를 컨텍스트로 줘도 실수가 많아서 내가 다시 해야 하는 일이 많음. 내 경험상 Opus, Astra, Argon, Gemini Flash 3.8, Sol이 훨씬 잘함.

댓글 0

아직 댓글이 없음.첫 댓글 써보기

댓글 작성

로그인 후 댓글을 작성할 수 있음.로그인

사진을 여기로 끌어다 놓거나이미지 · 파일당 최대 1 MB

해외반응

번호제목작성자작성일조회추천
5358257RTX 5090 실거래가가 9천 달러 넘었다는 글에 나온 반응N문익점조회6추천0
5358256소행성서 DNA와 RNA 염기 5종 발견됐다는 소식에 나온 질문N문익점조회6추천0
5358255뉴진스 데뷔 계약서 내용에 해외 팬들 갑론을박N문익점조회6추천0
5358254한국 1인당 GDP가 일본보다 15% 높다는 글에 나온 반응N문익점조회7추천0
5358253호날두 국대 은퇴 소식에 아쉽다는 축구팬들N문익점조회5추천0
5358252죽은 줄 알았던 캐릭터가 살아 돌아오는 전개 성공작 뭐 있음N문익점조회5추천0
5358248윈도우 11 우클릭 메뉴 바꿀 수 있게 되자 나온 반응문익점조회9추천0
5358246AI 없었으면 더 나았을지도 모른다는 제프리 힌턴문익점조회8추천0
5358245깃허브 장애에 푸시도 풀도 안 된다는 개발자들문익점조회8추천0
5358242AMD가 4분기에 인텔 매출 처음으로 앞설 거라 함문익점조회0추천0
5358241복호화는 못 한다던 클로드가 랜섬웨어 파일 살려낸 썰문익점조회8추천0
5358240리센느 신곡 멜론 1위 소식에 놀란 해외팬들문익점조회10추천0
5358239빅뱅도 소파이 간다니까 다음 타자 누굴지 궁금한 해외팬들문익점조회10추천0
5358238새 철로 놓으려고 158년 된 기차역을 통째로 옮기는 네덜란드문익점조회8추천0
5358237프랑스 혈장 냉동고 해킹해 온도 설정을 110도로 바꿔놓음문익점조회7추천0
5358236브라질서 점유율 두 배로 뛴 BYD를 보는 현지 반응문익점조회6추천0
5358235할리우드 나루토 실사판 카카시 역부터 정해짐문익점조회6추천0
5358232반도체주 하락 속 인텔 주가를 두고 나온 얘기들문익점조회18추천0
5358231스팀 대체하기 어렵다는 말에 나온 이용자들 반응문익점조회23추천0
5358230AI 친구가 외로움과 자존감에 도움이 된다는 연구 얘기문익점조회23추천0